 ИИ Дайджест
DiffuSpace открыла веса Clover-35B-A3B-Preview — диффузионной модели для программирования и агентов
DiffuSpace выпустила текстовую MoE-модель с 35 млрд параметров, примерно 3 млрд активных параметров на токен и лицензией Apache 2.0. Clover генерирует текст блоками; заявленные преимущества в скорости и агентных задачах пока подтверждены только тестами разработчика.
30 октября 2026 года DiffuSpace представила Clover-35B-A3B-Preview и опубликовала веса модели под Apache 2.0. Это предварительная версия текстовой модели с архитектурой Mixture-of-Experts: из 35 млрд параметров на каждый токен активируется примерно 3 млрд. Основные заявленные применения — программирование и работа агентов с инструментами.
По карточке модели, Clover создана на основе Qwen3.6-35B-A3B и поддерживает контекст до 131 072 токенов, включая запрос и ответ. Внутри блока замаскированные позиции заполняются параллельно по мере достижения достаточной уверенности; завершённый блок становится контекстом для следующего. В реализации Hugging Face размер блока по умолчанию равен 32 токенам, порог уверенности — 0,95.
Для такой генерации команда переработала Gated DeltaNet: предыдущий контекст хранится в сжатом рекуррентном состоянии, а токены текущего блока взаимодействуют через двунаправленное внимание. Такая схема позволяет учитывать соседние позиции внутри ещё формируемого блока.
Что показали тесты разработчика
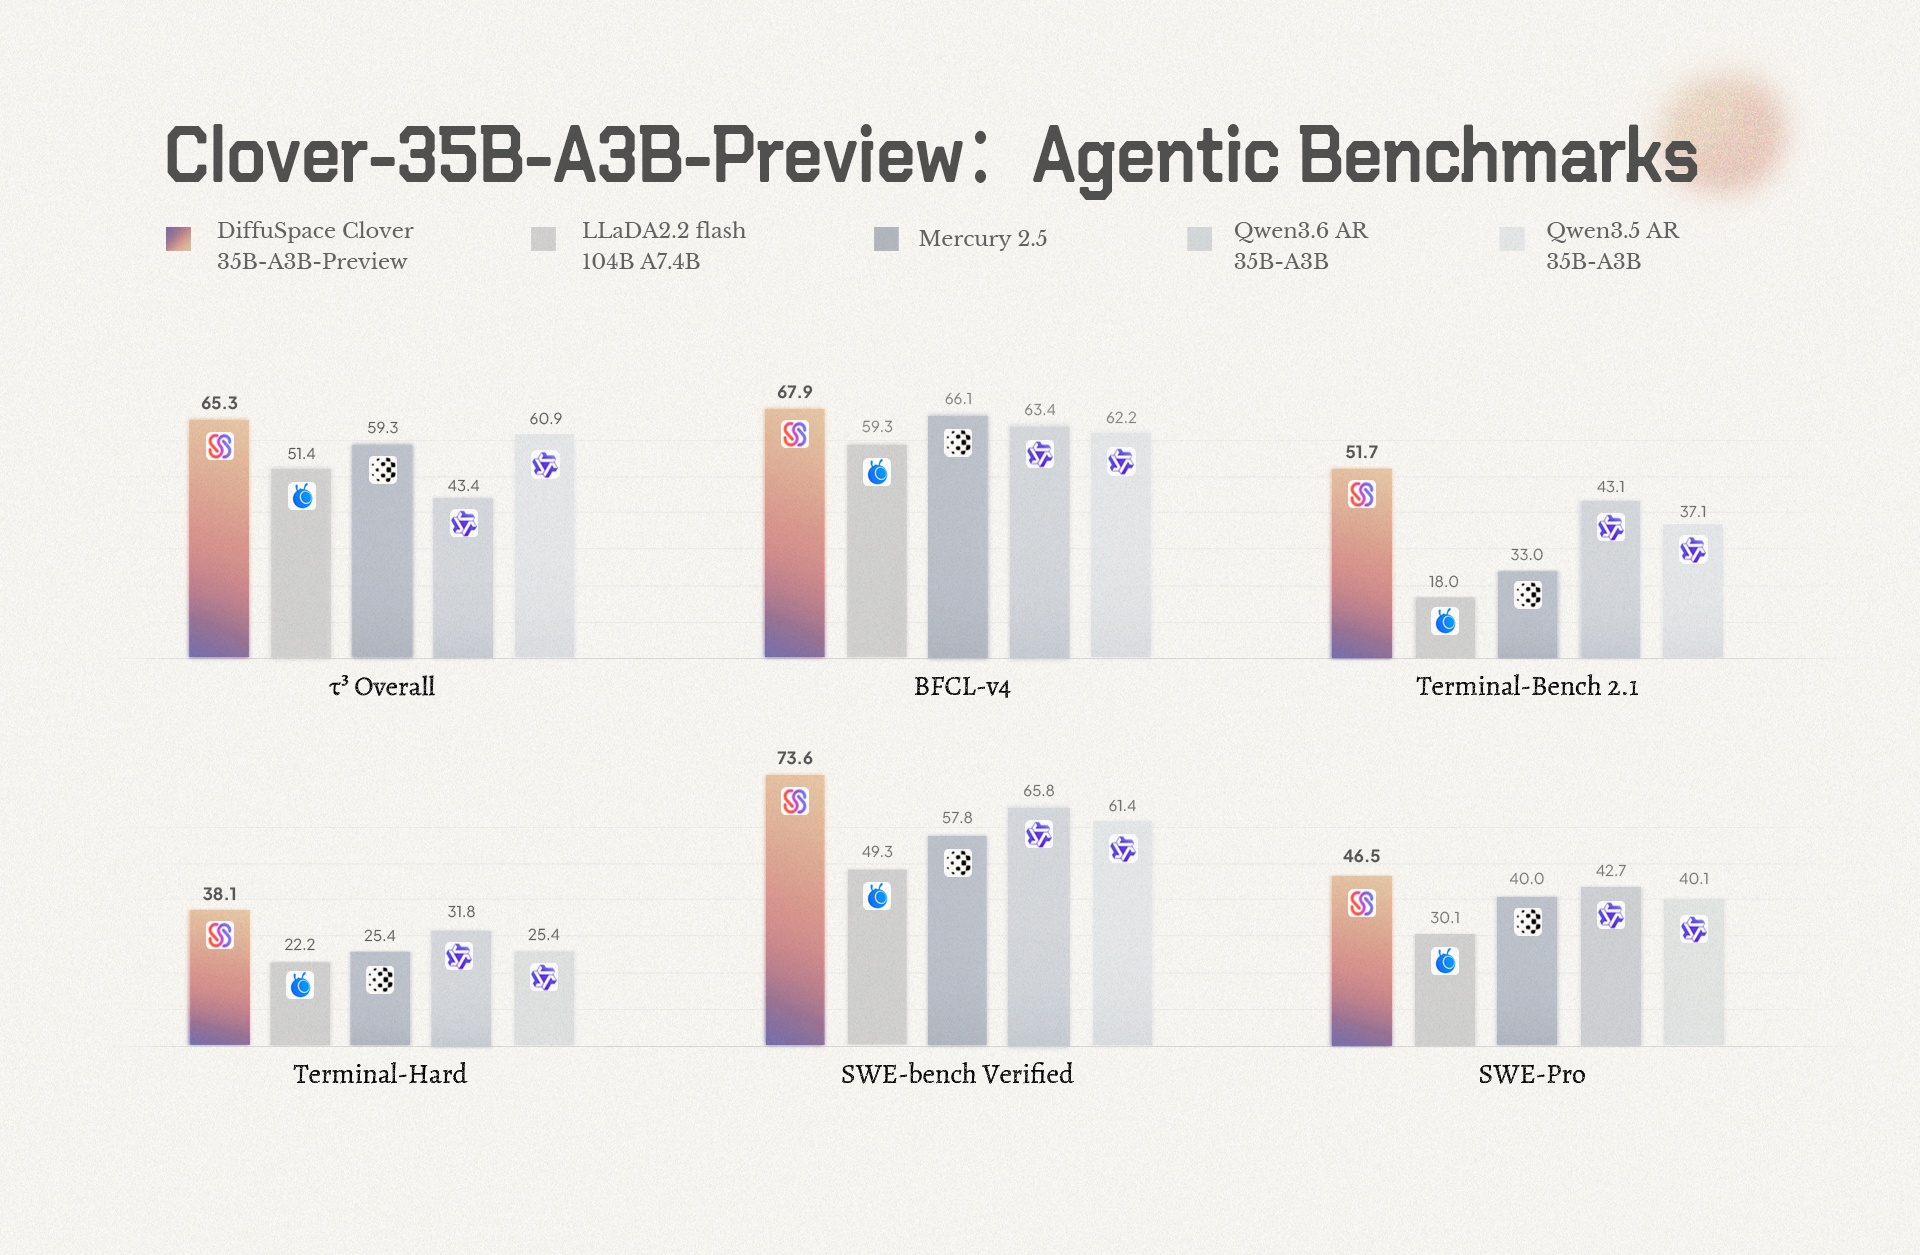
В опубликованном сравнении Clover получила 73,6 на SWE-bench Verified, 51,7 на Terminal-Bench 2.1 и 65,3 на τ³ Overall. Команда сообщает о лидерстве во всех шести включённых агентных тестах среди сравниваемых моделей, в том числе Qwen3.6-35B-A3B, Qwen3.5-35B-A3B, LLaDA2.2 flash и Mercury 2.5. Это результаты авторов; независимого подтверждения в проверенных материалах нет.
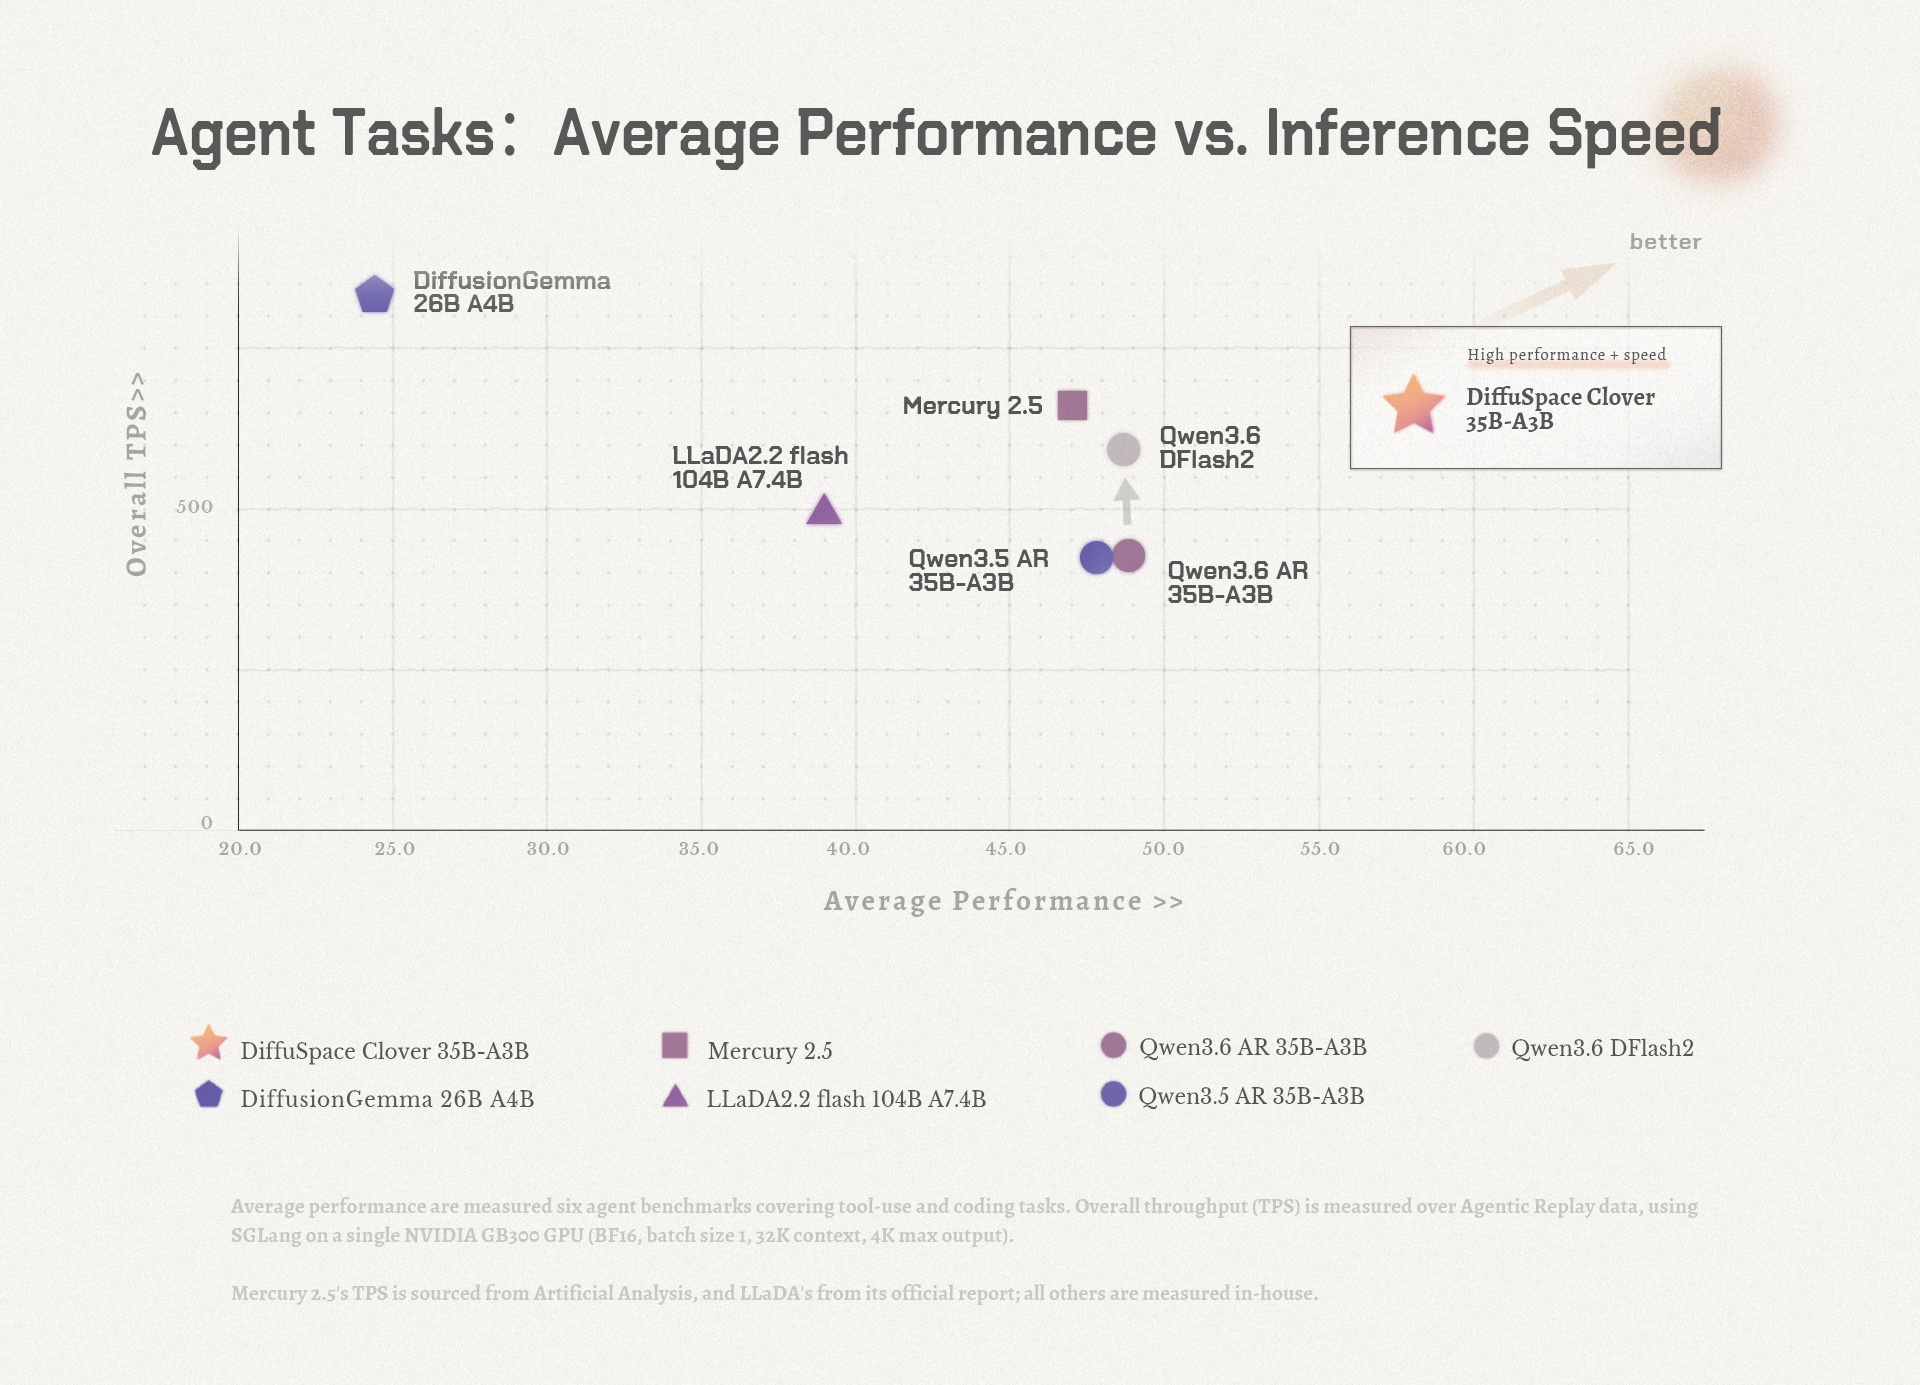
На внутренних агентных нагрузках авторы заявляют скорость 680 токенов/с на одной NVIDIA GB300 при BF16 и размере пакета 1. Этот показатель характеризует конкретную конфигурацию генерации: переносить его на другое оборудование или считать скоростью выполнения всей агентной задачи нельзя.
Как попробовать и какие есть ограничения
В официальном репозитории приведён пример запуска через Transformers 5.19.0 и PyTorch 2.10 или новее. Для весов BF16 требуется около 69 ГБ памяти, дополнительно нужна память для состояния инференса. Пример использует trust_remote_code=True и позволяет включить режим рассуждений через enable_thinking=True.
Авторы рекомендуют собственную реализацию SGLang для обслуживания запросов и оценки качества; для llama.cpp заявлено самоспекулятивное декодирование. При этом README прямо указывает, что код этих бэкендов и инструкции по настройке ещё будут добавлены. Публикация весов и рабочего пути через Transformers поэтому не означает, что весь заявленный набор интеграций уже доступен в репозитории.
У предварительной версии остаются ограничения: длинные ответы могут становиться повторяющимися, а численные различия между реализацией PyTorch и ядрами SGLang способны менять сгенерированный текст даже при одинаковых настройках. Для собственной оценки стоит фиксировать бэкенд и параметры декодирования, измеряя одновременно качество решения и полное время выполнения задачи.
Источники
-
DiffuSpace Core TeamОсновной источникClover-35B-A3B-Preview: A New Way for Intelligence ↗
-
DiffuSpaceDiffuspace/Clover-35B-A3B-Preview ↗
-
DiffuSpaceClover-35B-A3B-Preview ↗
-
DiffuSpaceClover-35B-A3B-Preview: A New Way for Intelligence ↗